
Нарочная случайность в ИИ для роботов улучшила результаты
Инженеры из Северо-Западного университета, США, разработали новый алгоритм искусственного интеллекта (ИИ) специально для робототехники. Помогая таким устройствам быстро и надёжно развивать сложные навыки, метод значительно повышает практичность и безопасность роботов.
Алгоритм получил название Maximum Diffusion Reinforcement Learning (MaxDiffRL), что можно перевести как «усиленное обучение с максимальным рассеянием». Программное обеспечение (ПО) побуждает роботов исследовать окружающую среду наиболее случайным образом ради всестороннего опыта.
Нарочито заложенная случайность улучшает качество данных, собираемых роботами вокруг себя. В компьютерной модели виртуальные устройства обучались быстрее и эффективнее, повышая тем самым надёжность и производительность.
При тестировании в сравнении с иными видами ИИ компьютерные имитации с использованием алгоритма MaxDiffRL неизменно превосходили прочие самые современные модели. Фактически, новый алгоритм работает настолько хорошо, что роботы выучивают новые задачи, а затем успешно выполняют их при первой же попытке. То есть благодаря MaxDiffRL делают всё правильно с первого раза. Это резко контрастирует с существующими моделями ИИ, при которых обучение идёт методом проб и ошибок, то есть куда медленнее.
— Томас Берруэта, руководитель исследования.
Обычно для тренировки алгоритмов машинного обучения исследователи и разработчики используют большие объёмы данных, которые тщательно фильтруются и обрабатываются людьми. ИИ учится на этих данных действительно методом проб и ошибок, пока не достигнет оптимальных результатов. Процесс этот хорошо работает для софтверных систем, в форме ПО, таких как ChatGPT и Google Gemini. Но метод не столь эффективен для воплощённых, физических, устройств с ИИ, таких как роботы. Вот почему нормально, чтобы роботы собирали информацию самостоятельно, без копания людей в данных.
Чтобы протестировать новый алгоритм, исследователи запустили компьютерное моделирование, дав задание продолговатым виртуальным роботам выполнять ряд стандартных задач. В целом модели с MaxDiffRL, обучались быстрее других. Они также корректно выполняли команды намного последовательнее и надёжнее, чем другие «змейки». Прячём, как уже было сказано, с первой попытки, начав без каких-либо предварительных знаний о ситуации.
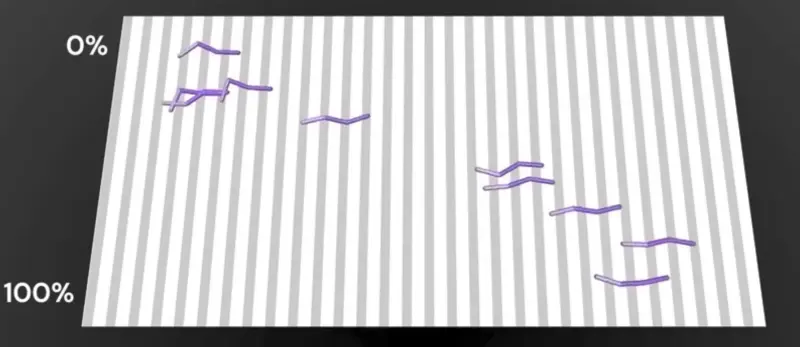
Берруэта заявил, что созданные им с коллегами роботы были быстрее и манёвреннее. А это стало бы огромным преимуществом для реальных устройств.
Кстати, MaxDiffRL необязательно использовать только для перемещающихся роботов. Например, он вполне бы подошёл для манипулятора на кухне, который учится загружать различную утварь в посудомоечную машину. Потенциально применение — беспилотные автомобили и летательные аппараты, домашняя робототехника и автоматизация различных процессов.
Итак, MaxDiffRL — это алгоритм широкого назначения, его можно использовать для множества целей. Исследователи надеются, что созданное ими ПО решит фундаментальные проблемы отрасли, и в конечном итоге проложит путь к надёжному принятию решений в робототехнике.
Алгоритм получил название Maximum Diffusion Reinforcement Learning (MaxDiffRL), что можно перевести как «усиленное обучение с максимальным рассеянием». Программное обеспечение (ПО) побуждает роботов исследовать окружающую среду наиболее случайным образом ради всестороннего опыта.
Нарочито заложенная случайность улучшает качество данных, собираемых роботами вокруг себя. В компьютерной модели виртуальные устройства обучались быстрее и эффективнее, повышая тем самым надёжность и производительность.
При тестировании в сравнении с иными видами ИИ компьютерные имитации с использованием алгоритма MaxDiffRL неизменно превосходили прочие самые современные модели. Фактически, новый алгоритм работает настолько хорошо, что роботы выучивают новые задачи, а затем успешно выполняют их при первой же попытке. То есть благодаря MaxDiffRL делают всё правильно с первого раза. Это резко контрастирует с существующими моделями ИИ, при которых обучение идёт методом проб и ошибок, то есть куда медленнее.
С нашей платформой каждый раз, когда вы включаете робота, он делает именно то, о чём его попросили
— Томас Берруэта, руководитель исследования.
Обычно для тренировки алгоритмов машинного обучения исследователи и разработчики используют большие объёмы данных, которые тщательно фильтруются и обрабатываются людьми. ИИ учится на этих данных действительно методом проб и ошибок, пока не достигнет оптимальных результатов. Процесс этот хорошо работает для софтверных систем, в форме ПО, таких как ChatGPT и Google Gemini. Но метод не столь эффективен для воплощённых, физических, устройств с ИИ, таких как роботы. Вот почему нормально, чтобы роботы собирали информацию самостоятельно, без копания людей в данных.
Чтобы протестировать новый алгоритм, исследователи запустили компьютерное моделирование, дав задание продолговатым виртуальным роботам выполнять ряд стандартных задач. В целом модели с MaxDiffRL, обучались быстрее других. Они также корректно выполняли команды намного последовательнее и надёжнее, чем другие «змейки». Прячём, как уже было сказано, с первой попытки, начав без каких-либо предварительных знаний о ситуации.
Берруэта заявил, что созданные им с коллегами роботы были быстрее и манёвреннее. А это стало бы огромным преимуществом для реальных устройств.
Кстати, MaxDiffRL необязательно использовать только для перемещающихся роботов. Например, он вполне бы подошёл для манипулятора на кухне, который учится загружать различную утварь в посудомоечную машину. Потенциально применение — беспилотные автомобили и летательные аппараты, домашняя робототехника и автоматизация различных процессов.
Итак, MaxDiffRL — это алгоритм широкого назначения, его можно использовать для множества целей. Исследователи надеются, что созданное ими ПО решит фундаментальные проблемы отрасли, и в конечном итоге проложит путь к надёжному принятию решений в робототехнике.
- Дмитрий Ладыгин
- youtu.be/P5Dpb21es58
Наши новостные каналы
Подписывайтесь и будьте в курсе свежих новостей и важнейших событиях дня.
Рекомендуем для вас
Жители этого американского города были уверены, что переживут ураган. К утру было уже 12 000 погибших
Самое поразительное, что всех этих чудовищных человеческих жертв вполне можно было избежать. Но руководство Галвестона самонадеянно не желало оглядываться по...
Катастрофа по минутам: ученые подробно расписали, что произойдет, если начнется извержение Йеллоустоунского супервулкана
Моделирование показало две главных новости: очень плохую для США и нормальную для всего человечества...
1400 землетрясений: КНДР прекратила ядерные испытания в 2017 году, но толчки идут до сих пор. Почему?
Эксперты говорят: есть процессы, которые сложно запустить, но еще труднее потом остановить...
Огонь по своим: ИИ, работающий на воронежскую администрацию, в итоге завалил штрафами своих хозяев
Эксперты говорят: «Добро пожаловать в новую реальность!»...
«Место силы» на острове Ольхон оказалось источником магнетизма: что же скрывается под Байкалом?
Пока ясно можно сказать только одно: источник аномалии находится неглубоко...
Летящие в огонь: пока большинство животных спасаются бегством, некоторые хищные птицы «наживаются» на пожарах
Есть много фактов, что огненные ястребы не просто любят пламя, а сознательно разжигают его...
США официально признали, что размещают оружие в космосе. Как на это ответит Россия и другие ведущие страны
Почему даже американские эксперты, что это решение может больше навредить самому Вашингтону...
Как СССР рывком обошел США на пути в космос: Росархив раскрыл уникальные документы о Большом телескопе в Крыму
...
В Пекине запретили дроны: почему теперь за хранение не только штраф, но и 10 суток ареста?
Ситуация парадоксальная: страна, которая продвинула коптеры по всему миру, теперь максимально их ограничивает...
Архивы, полные тайн: оказалось, в панцирях улиток спрятаны поразительные истории
Ядерные взрывы, скачки климата и другие секреты прочитали ученые в завитках домиков сухопутных моллюсков...