
Искусственный интеллект EfficientViT в девять раз улучшил зрение у беспилотных автомобилей
Автономное транспортное средство должно быстро и точно распознавать объекты, к которым приближается, от стоящего на холостом ходу грузовика доставки на углу до велосипедиста, несущегося к перекрёстку.
Новую систему искусственного интеллекта (ИИ) представили исследователи из Массачусетского технологического института (MIT) и совместная лаборатория MIT-IBM Watson AI Lab. EfficientViT — это мощная модель компьютерного зрения, которая быстро разбивает изображении на фрагменты по значению (семантике) с высоким разрешением в реальном времени. То есть благодаря изобретению движущийся автомобиль без водителя сразу же распознаёт, где перед ним люди и другие машины. Беспилотный транспорт благодаря бортовому компьютеру с EfficientViT может определить за доли секунды, что означает: обрабатывается каждый пиксель изображения с высоким разрешением, чтобы не упускать объекты из виду.
Но эта задача, известная как семантическая сегментация, сложна и требует огромного объёма вычислений. Иные модели для этого напрямую анализируют взаимодействие между каждой парой пикселей на изображении. Поэтому их вычисления множатся в квадратной степени по мере увеличения разрешения. Так что даже точные модели слишком медленны для обработки изображений на периферийном устройстве, таком как смартфоны. Чтобы ускорить систему, исследователи MIT разработали иную модель семантической сегментации. Она обеспечивает те же возможности, что и другие, но с линейной вычислительной сложностью и аппаратно-эффективными операциями.
В результате получилась новая серия моделей компьютерного зрения высокого разрешения, которые при развёртывании на мобильном устройстве работают в девять раз быстрее, чем прочие. Важно отметить, что эта новая серия моделей продемонстрировала такую же или лучшую точность, чем альтернативы.
Необходимые для такого успеха преобразователи (трансформеры) изначально были созданы для обработки естественного языка. Они кодируют каждое слово в предложении как отличительный признак (маркер). А затем — генерируют карту внимания, которая фиксирует взаимосвязь каждого маркера с другими. Эта карта внимания помогает модели понимать текущее значение (контекст), когда та делает прогнозы.
Используя ту же концепцию для обработки изображений, преобразователь зрения разбивает видимое машиной на участки и кодирует каждый из них в маркер перед созданием карты внимания. При этом модель использует функцию подобия, которая напрямую изучает взаимодействие между каждой парой пикселей. Таким образом, модель развивает так называемое глобальное поле восприятия. То есть она может получить доступ ко всем частям изображения. Поскольку воспринимаемая сцена с высоким разрешением может содержать миллионы пикселей, разбитых на тысячи участков, карта внимания быстро становится огромной. И устройство начинает тормозить, как указано выше.
Для EfficientViT исследователи MIT использовали более простой механизм для построения карты внимания. Они заменили нелинейную функцию подобия линейной. Таким образом они могут изменять порядок операций, чтобы сократить общее количество вычислений без изменения функциональности. В их модели объём вычислений, необходимый для прогнозирования, с повышением разрешения картинки растёт линейно, по прямой, а не в квадратной степени.
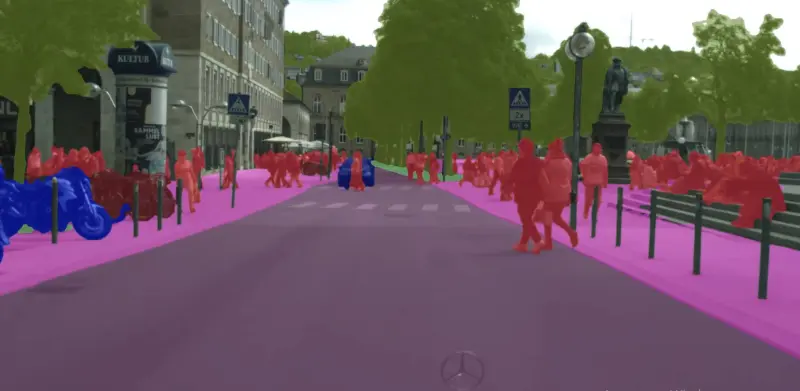
Но профессор Сон Хан, первый автор научной работы, признал, что и в таком случае «бесплатного обеда не бывает». То есть линейное внимание фиксирует только общий контекст изображения, теряя частную информацию, что ухудшает точность. Чтобы компенсировать недостаток, исследователи включили в свою модель два дополнительных компонента, каждый из которых лишь ненамного повышает объём вычислений. Один из них помогает модели фиксировать взаимодействия локальных объектов. Второй модуль обеспечивает многомасштабное обучение, помогая EfficientViT распознавать как большие, так и маленькие объекты.
Из-за необходимости тщательно сбалансировать производительность и экономичность, EfficientViT разработали с аппаратно-ориентированной архитектурой, чтобы модель было проще запускать на различных типах устройств.
Основываясь на полученных результатах, исследователи хотят применить этот метод для ускорения генеративных моделей машинного обучения, которые используются для создания новых изображений. Они также хотят продолжить масштабирование EfficientViT для других визуальных задач. Например — в медицине.
Новую систему искусственного интеллекта (ИИ) представили исследователи из Массачусетского технологического института (MIT) и совместная лаборатория MIT-IBM Watson AI Lab. EfficientViT — это мощная модель компьютерного зрения, которая быстро разбивает изображении на фрагменты по значению (семантике) с высоким разрешением в реальном времени. То есть благодаря изобретению движущийся автомобиль без водителя сразу же распознаёт, где перед ним люди и другие машины. Беспилотный транспорт благодаря бортовому компьютеру с EfficientViT может определить за доли секунды, что означает: обрабатывается каждый пиксель изображения с высоким разрешением, чтобы не упускать объекты из виду.
Но эта задача, известная как семантическая сегментация, сложна и требует огромного объёма вычислений. Иные модели для этого напрямую анализируют взаимодействие между каждой парой пикселей на изображении. Поэтому их вычисления множатся в квадратной степени по мере увеличения разрешения. Так что даже точные модели слишком медленны для обработки изображений на периферийном устройстве, таком как смартфоны. Чтобы ускорить систему, исследователи MIT разработали иную модель семантической сегментации. Она обеспечивает те же возможности, что и другие, но с линейной вычислительной сложностью и аппаратно-эффективными операциями.
В результате получилась новая серия моделей компьютерного зрения высокого разрешения, которые при развёртывании на мобильном устройстве работают в девять раз быстрее, чем прочие. Важно отметить, что эта новая серия моделей продемонстрировала такую же или лучшую точность, чем альтернативы.
Необходимые для такого успеха преобразователи (трансформеры) изначально были созданы для обработки естественного языка. Они кодируют каждое слово в предложении как отличительный признак (маркер). А затем — генерируют карту внимания, которая фиксирует взаимосвязь каждого маркера с другими. Эта карта внимания помогает модели понимать текущее значение (контекст), когда та делает прогнозы.
Используя ту же концепцию для обработки изображений, преобразователь зрения разбивает видимое машиной на участки и кодирует каждый из них в маркер перед созданием карты внимания. При этом модель использует функцию подобия, которая напрямую изучает взаимодействие между каждой парой пикселей. Таким образом, модель развивает так называемое глобальное поле восприятия. То есть она может получить доступ ко всем частям изображения. Поскольку воспринимаемая сцена с высоким разрешением может содержать миллионы пикселей, разбитых на тысячи участков, карта внимания быстро становится огромной. И устройство начинает тормозить, как указано выше.
Для EfficientViT исследователи MIT использовали более простой механизм для построения карты внимания. Они заменили нелинейную функцию подобия линейной. Таким образом они могут изменять порядок операций, чтобы сократить общее количество вычислений без изменения функциональности. В их модели объём вычислений, необходимый для прогнозирования, с повышением разрешения картинки растёт линейно, по прямой, а не в квадратной степени.
Но профессор Сон Хан, первый автор научной работы, признал, что и в таком случае «бесплатного обеда не бывает». То есть линейное внимание фиксирует только общий контекст изображения, теряя частную информацию, что ухудшает точность. Чтобы компенсировать недостаток, исследователи включили в свою модель два дополнительных компонента, каждый из которых лишь ненамного повышает объём вычислений. Один из них помогает модели фиксировать взаимодействия локальных объектов. Второй модуль обеспечивает многомасштабное обучение, помогая EfficientViT распознавать как большие, так и маленькие объекты.
Из-за необходимости тщательно сбалансировать производительность и экономичность, EfficientViT разработали с аппаратно-ориентированной архитектурой, чтобы модель было проще запускать на различных типах устройств.
Основываясь на полученных результатах, исследователи хотят применить этот метод для ускорения генеративных моделей машинного обучения, которые используются для создания новых изображений. Они также хотят продолжить масштабирование EfficientViT для других визуальных задач. Например — в медицине.
- Дмитрий Ладыгин
- youtube.com
Наши новостные каналы
Подписывайтесь и будьте в курсе свежих новостей и важнейших событиях дня.
Рекомендуем для вас
Тайна скифской ДНК: что поразило российских ученых, когда они заглянули в геном легендарных кочевников древности
Оказалось, что 2500 лет подряд историки ошибались в происхождении этого народа. Теории и учебники придется серьезно переписать...
Выход на новый уровень: почему Россия возрождает проводное радио, а Китай давно прокачал этот вид связи
У старой технологии обнаружился огромный потенциал, который поможет миллионам людей...
Запретный остров у берегов Исландии: суша, появившаяся в 1963 году, до сих пор закрыта почти для всех
Но ученым надо поторопиться, уникальный объект исчезает в буквальном смысле на глазах...
Назад в будущее: в России вернут проводное радио. Зачем? Почему спорят эксперты?
В технологию уже вложено более миллиарда рублей, а МЧС называет проводное радио лучшим способом оповещения на сегодня...
Как же на самом деле умерла Клеопатра: почему даже древние историки не смогли прийти к согласию в этом вопросе
Скорее всего, историю об укусе змеи запустил лично император Октавиан, чтобы опорочить египетскую царицу...
Прорыв в берестяных грамотах: 445 неизвестных слов, эффект Лукерьи, реальный русский язык XI–XV веков
Поразительно, но произношение 900-летней давности до сих пор присутствует в нашем языке...
Метеорит и пришельцы ни при чем: российский геолог объяснил происхождение аномалии в сибирской тайге
Кольцевую структуру видно даже со спутника, но добраться до нее крайне сложно...
Америка проигрывает болезни, которую когда-то победила с большим трудом
Положение США усугубляют действия президента Трампа и его чиновников...
Древние деревья помогли раскрыть дело 3500-летней давности: когда пал Вавилон?
Ученые до последнего момента не знали этой даты, потому что в великом городе не было… нормального календаря...
Неожиданный поворот в деле таинственного астероида 1998 KY26: он может быть… потерянным советским зондом
В этом уверен американский астрофизик Аве Лоеб. Какие доказательства предлагает известный ученый?...
Верблюды-вампиры бродили по Америке 13 миллионов лет назад: зачем им вообще понадобились такие жуткие клыки
Ученые говорят: это была эпоха, когда североамериканским континентом правили верблюды...
Не НЛО, но что тогда: ученая объяснила появление светящихся столбов над Барнаулом
Что интересно, это уникальное явление можно увидеть не только зимой и не только в Сибири...
200-летний секрет казненной королевы: почему Мария-Антуанетта была уже обречена на скорую и мучительную гибель
Одежда рассказала не только о последних днях королевы, но и открыла судьбу 9-летнего французского принца...
Куда бить по астероиду, чтобы спасти Землю: ученые рассчитали идеальный ядерный выстрел
Почему раньше так не умели и насколько при выстреле важна форма космического тела...
Эти странные деревья изменили облик всей планеты: в Англии найден самый древний лес в истории
Поразительно, но Земля стала другой всего за 4 миллиона лет. И это событие старше колец Сатурна...