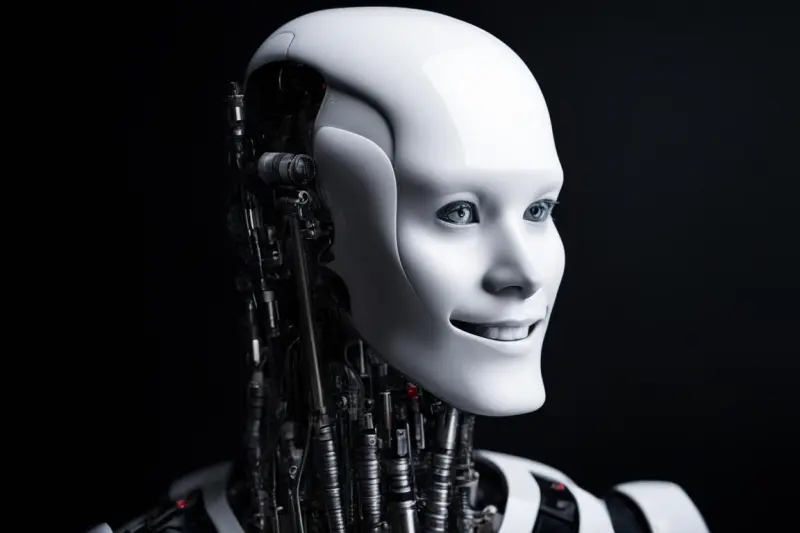
Нешуточная задача: Российские ученые обучают ИИ чувству юмора
Комплексное исследование способности нейронных сетей распознавать и понимать юмор провела команда ученых с факультета компьютерных наук Национального исследовательского университета «Высшая школа экономики». Исследование проведено в рамках проекта «Научно-учебная лаборатория моделей и методов вычислительной прагматики». Александр Баранов, аспирант факультета компьютерных наук НИУ ВШЭ, представил результаты на конференции, проходящей в Сингапуре. Финансовую поддержку его участия в мероприятии оказал Национальный исследовательский университет «Высшая школа экономики».
Исследование показало, что для повышения точности и эффективности распознавания юмора необходимо изменить текущую методологию, используемую при разработке наборов данных, используемых для обучения этих сетей.
С середины 2000-х годов ученые посвятили свои исследования распознаванию юмора, уделяя особое внимание классификации шуток на смешные и несмешные. Для проведения этих исследований исследователи собирали и маркировали наборы данных в рамках стандартизированной структуры. Однако группа ученых из Высшей школы экономики предложила новый подход к построению таких наборов данных. Их идея состоит в том, чтобы сделать их более разнообразными, тем самым гарантируя, что они не будут ограничиваться определенным типом юмора.
Кроме того, они утверждают, что размер наборов данных не обязательно должен быть большим для достижения точных результатов. В настоящее время голосовые помощники способны только цитировать готовые шутки и не имеют возможности создавать собственные или распознавать юмористические интонации в тексте. Однако пользователи голосовых помощников на базе искусственного интеллекта требуют более человеческого взаимодействия, включая возможность распознавать и создавать объекты юмора.
Распознать юмор может быть довольно сложно из-за отсутствия формальных стандартов, позволяющих определить, что считать смешным, а что нет. В настоящее время большинство наборов данных, используемых для обучения и оценки моделей распознавания юмора, преимущественно состоят из каламбуров. Однако обнаружить сарказм и иронию еще сложнее, как и уловить ситуационный юмор, который требует понимания окружающего контекста или культурных норм.
По словам доцента факультета компьютерных наук Высшей школы экономики Павла Браславского, основной задачей ученых было оценить переносимость и стабильность моделей, прошедших обучение на различных наборах данных. В случае переносимости речь идет о том, насколько эффективно модель, обученная на определенном наборе данных с определенным типом юмора, может точно идентифицировать и понимать другой тип юмора. Сложность проведения такой оценки заключается в том, что юмор может проявляться в разных формах и вариациях, что затрудняет прогнозирование того, как будет разворачиваться тренировочный процесс.
Чтобы оценить стабильность нейронной сети, ученые провели эксперименты с использованием «состязательных атак». Эти атаки включали преднамеренную попытку обмануть нейронную сеть, предоставляя ей текст, который напоминал юмористическое предложение, но на самом деле был несмешным. Манипуляция заключалась в использовании аналогичной структуры предложения, но с заменой каламбура неюмористическим словом. Цель заключалась в том, чтобы увидеть, насколько легко сеть можно обмануть и будет ли она по-прежнему воспринимать юмор там, где его нет. Чем более устойчивой была сеть к такой обманной тактике, тем выше считалась ее стабильность.
Модели прошли обучение с использованием различных наборов данных по распознаванию юмора, а также комбинаций таких наборов. Кроме того, исследователи провели тесты, используя диалоги, извлеченные из известных литературных произведений, таких как «Алиса в стране чудес» Льюиса Кэрролла, «Лавка древностей» Чарльза Диккенса и «Трое в лодке, не считая собаки» Джерома К. Джерома. Кроме того, модели оценивались с использованием диалогов из популярных телешоу, таких как «Ходячие мертвецы» и «Друзья», а также подборки саркастических твитов.
При проведении эксперимента с различными моделями выяснилось, что некоторые модели были чрезмерно тренированы и имели склонность воспринимать все как юмористическое. Чтобы оценить их понимание, этим моделям был представлен знаменитый роман Чарльза Диккенса «Лавка древностей», широко известный своим меланхоличным повествованием. Удивительно, но было замечено, что часть моделей придерживалась убеждения, что все диалоги, заимствованные из литературы XIX века, по своей сути комичны. Более того, эти модели даже расширили свое восприятие юмора, включив в него любой контент, который значительно отличается от современных новостей 21 века.
Использование моделей, обученных игре слов, показало тенденцию к увеличению количества ошибок, когда одно слово в несмешном тексте заменяется согласной. Кроме того, исследования показали, что нейронные сети, обученные на меньших порциях данных, демонстрируют большую способность понимать юмор по сравнению с теми, которые обучены на больших объемах тех же данных. Эти результаты привели авторов к выводу, что нынешним наборам данных не хватает широты, что приводит к ограниченному представлению юмора и, в конечном итоге, ставит под угрозу точность распознавания шуток.
Чтобы повысить эффективность моделей распознавания юмора, исследователи выдвинули предложение изменить существующие методы обучения и оценки. Они утверждают, что существующим наборам данных не хватает разнообразия и они не могут точно отражать повседневные разговоры и естественное общение. Чтобы исправить это, необходимо разработать новые наборы данных, охватывающие более широкий спектр контекстов и взаимодействий. Одним из многообещающих направлений является использование больших языковых моделей, таких как ChatGPT, которые были обучены на огромных объемах разнообразных данных. Эти модели продемонстрировали похвальные результаты в распознавании юмора, что побудило ученых предположить, что их успех обусловлен обширным набором данных, на которых они обучались.
Сегодня внимание ученых сосредоточено исключительно на бинарном распознавании юмора, то есть категоризации шуток: либо смешно, либо не смешно. Предстоит пройти еще долгий путь, прежде чем машина сможет определить различные оттенки юмора, различать сарказм и иронию и точно детектировать ситуативный и контекстуальный юмор. В настоящее время голосовые помощники полагаются на заранее запрограммированные ответы, которые фильтруются на основе слов пользователя, чтобы определить, какую шутку произнести. К сожалению, эти запрограммированные реакции часто кажутся искусственными и лишены желаемой естественности. Потребность в искусственном интеллекте, способном проявить большую человечность, очевидна, но удовлетворение этого требования, несомненно, будет непростой задачей.
Наши новостные каналы
Подписывайтесь и будьте в курсе свежих новостей и важнейших событиях дня.
Рекомендуем для вас
3700-летний вирус, спрятанный в средневековых книгах, только что убил 500 тысяч животных
Сколько еще патогенов дремлет в библиотечных хранилищах Европы и России, точно не скажет ни один ученый...
«Этого не должно происходить»: что ученые нашли в облаках Венеры
Там возможны абсолютно другие, просто невероятные формы жизни. И эксперименты это доказали...
Молилась и убивала: какой диагноз ставят Салтычихе психиатры и психологи?
Ученые говорят: феномен жестокости самой страшной помещицы России разгадан, но......
Супервспышка-1947: тогда Земля избежала триллиона бомб. Но успокоилось ли Солнце?
Астрофизики говорят, что нам очень повезло со звездой. Но шансы на глобальную катастрофу все-таки есть...
Карта 1587 года и Ноев ковчег: почему место совпало с раскопками на Арарате?
Длина «судна», кстати, тоже совпала, и это не может не настораживать...
«Выстрел» прямо в Землю: астрономы обнаружили черную дыру, выбрасывающую струю в сторону нашей планеты
Ученые рассказали, как это поможет разгадать важную космическую тайну...
Камчатка 1000 лет назад: археологи заглянули в исчезнувший мир из космоса
Предков этих людей изгнало мощное извержение вулкана, но через столетия они вернулись в родные земли...
Жизнь за пределами Земли: что рассказала ученым межзвездная комета 3I/ATLAS?
Объект настолько древний, что его возраст крайне сложно представить. И это не единственная загадка пришельца из глубокого космоса...
Нашли тайную комнату в гробнице Тутанхамона: почему там может быть Нефертити?
Если гипотеза подтвердится, это будет крупнейшее археологическое открытие современной эпохи...
Астрономы поймали сигнал из космоса: пришельцы или помеха?
И почему главная проблема в том, что мы мастерски сами себе мешаем за пределами Земли?...
928 разбросанных костей в Гёбекли-Тепе: спустя 30 лет раскопок тайна древнейшего храма наконец-то раскрыта
Однако археологи признаются: от открытия им проще не стало. Напротив, все еще больше запуталось...
Черная смерть — двигатель прогресса: как эпидемия чумы в корне поменяла ход истории в Европе
Неожиданно: книгопечатание, отмена крепостного права, раскол западного христианства — это лишь немногие последствия пандемии...
Поделили Москву на «зоны влияния»: генетики рассказали, как живут крысиные «народы» столицы
Почему московские грызуны оказались «неуязвимыми мутантами» и зачем им реки для жизни?...
Тихий океан стал вести странно: молодая вода быстро стареет, а старая, наоборот, молодеет. В чем причина?
Особенно страдает северная часть океана. Но и есть хорошая новость...
Не хуже Тутанхамона: почему сокровища забытых цариц из Ассирии поразили ученых?
Особенно загадочной оказалось гробница II, причем ее тайна до конца не раскрыта и по сей день...
Таинственные пещерные иероглифы в Мексике раскрывают давно потерянную письменность
Оказалось, что разгадки лучше всего искать не в городах, а на склонах гор в глуши...