Генеративный ИИ сходит с ума, если переобучится на данных ИИ
Новое исследование искусственного интеллекта (ИИ) выявило ограничение в сетях текущего поколения, используемых в ChatGPT и Midjourney.
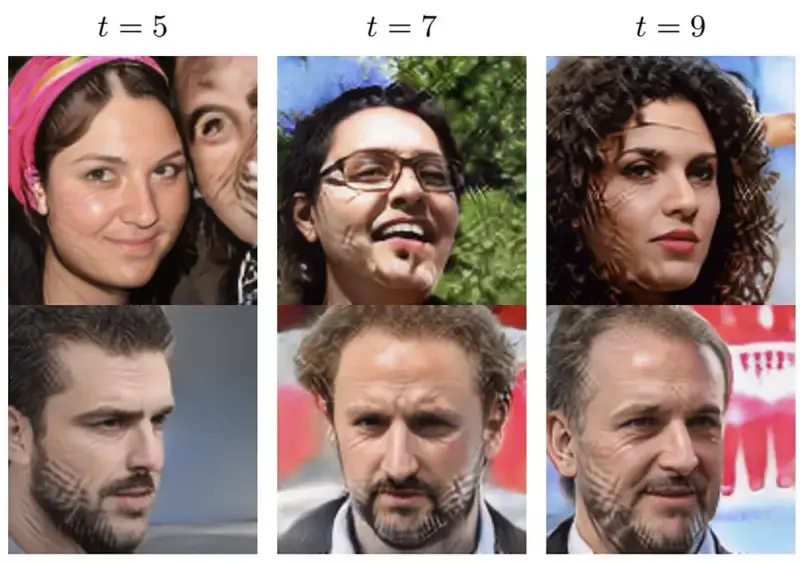
Уточним, что выходные данные ИИ — это текст, созданный ChatGPT, или изображения, порождённые моделью преобразования текста в картинку Stable Diffusion. Оказалось, что сети ИИ, обученные на выходных данных ИИ, как правило, сходят с ума после пяти циклов обучения на том, что сгенерировал сам ИИ. Это очевидно на титульной картинке к новости: по лицам словно прошлись напильником.
Выражение «сойти с ума» содержит в английском оригинале публикации не просто слово mad, «безумный», а аббревиатуру MAD — это сокращение от Model Autophagy Disorder, «расстройство с самопоеданием модели». Термин предложили учёные из двух университетов, Райса и Стэнфордского, которые участвовали в исследовании.
Понятие MAD означает явление, когда модели ИИ и качество результатов ухудшаются при повторном обучении на данных, сгенерированных ИИ. Как следует из термина, модель, по сути, съедает саму себя, как мифический змей Уроборос. Она теряет информацию о хвостах (крайностях) исходного распределения данных и начинает выдавать результаты, которые в большей степени соответствуют среднему значению.
По сути, обучение больших языковых моделей (LLM) на своих собственных (или чужих) выходных данных создаёт эффект конвергенции, сближения, данных, из которых состоит сама LLM. Последовательные итерации (обработки) при обучении на сгенерированных LLM данных приводят к тому, что модель теряет доступ к менее распространённым элементам.
Данные на краях, которые имеют меньше вариаций и менее представлены, по существу исчезают. Из-за этого остающиеся в модели элементы менее разнообразны и регрессируют к среднему значению. Согласно результатам исследования, требуется около пяти раундов итерации, пока не исчезнут хвосты исходного распределения — и это момент, когда наступает то самое безумие, MAD. Влияет ли расстройство аутофагии (самопоедания) на все модели ИИ, в точности пока неизвестно. Исследователи успели обкатать проблему на архитектуре нейронной сети типа автокодировщика, модели гауссовой смеси (GMM) и большой языковой модели.
Так уж получилось, что все типы моделей, которые могут сойти с ума, широко распространены. Так, автокодировщики могут прогнозировать популярность для соцсетей, сжимать изображения, подавлять шумы в картинках и генерировать новый графический контент. А модели гауссовой смеси используют для оценки плотности, кластеризации и сегментации изображений, что делает их особенно полезными для статистики и наук о данных.
Что касается больших языковых моделей, то они составляют основу современных популярных приложений для чат-ботов, в том числе ChatGPT от OpenAI и AI Claude от Anthropic. И они тоже склонны сходить с ума при обучении на своих собственных выходных данных. При растущей значимости алгоритмических моделей ИИ и в корпоративной сфере, и для рядовых пользователей — это проблема.
Итак, исследователи заглянули в чёрный ящик ИИ. И практически разрушили всякую надежду на то, что человечество обрело бесконечный источник данных. На самом деле определённые модели ИИ оказались, образно говоря, беговым колесом для хомячка: машина загружает в него данные, а затем возвращает внутрь его собственные данные, чтобы сгенерировать больше данных, которые затем возвращаются обратно.
Такой алгоритмический фанатизм не учитывает элементы, которые были изначально в меньшинстве. Результат налицо, точнее, опять-таки на лицах на заглавной картинке.
Другой важный момент — проблема происхождения данных. Теперь особенно важно иметь возможность отделять «оригинальные» данные от «искусственных». Если вы не можете определить, какие данные были созданы LLM или приложением для генерации картинки, вы можете случайно включить их в обучающие данные для вашего продукта следующего поколения.
К сожалению, этот корабль уже отчалил, пишет издание Tom’s Hardware. Уже создано некое количество немаркированных данных, созданных сетями такого типа и включённых в другие системы. Даже если бы у нас была копия всего интернета до взрыва популярности ChatGPT или Midjourney, во всемирную паутину уже давно ежедневно поступает контент, «придуманный» ИИ. И это не говоря уже об огромных объёмах того, что все эти машинные умы успели наштамповать.
Однако знание о проблеме означает, что поиск водяного знака, который безошибочно идентифицирует порождённый ИИ контент, теперь стал ещё важнее. И пропорционально выросла ответственность за маркировку того, что создано ИИ. (А ещё нарисовалась максимально прибыльная задача для разработчиков).
Однако существуют и другие способы компенсировать описанные отклонения. Один из них — просто изменить вес (в смысле науки о данных). Если увеличить релевантность или частоту результатов в хвостах распределения, они естественным образом будут двигаться вдоль колоколообразной кривой, ближе к среднему значению. Из этого следует, что тогда они были бы гораздо менее подвержены обрезке при самогенерирующемся обучении. Да, модель по-прежнему будет терять данные по краям кривой, но они будут не только там. Но это создаёт новую проблему — последствий тонкой настройки модели и того, как это повлияет на результат.
Для каждого вопроса, на который нашли ответ, возникает ряд новых.
• истинности ответов модели, где отклонения известны как галлюцинации;
• является ли модель предвзятой и откуда берётся эта предвзятость — из самих ли обучающих данных или из процесса взвешивания, используемого для создания сети, или из MAD;
• что происходит, когда модели обучаются на своих собственных данных.
Раз уже пишут без кавычек, что ИИ сходит с ума, то возможно и другое сравнение. Люди без доступа к новому опыту тоже деградируют, становясь эхо-камерами чего-то прежнего. Когда кто-то или что- то обучаются на собственных выходных данных, — это не к добру.
Уточним, что выходные данные ИИ — это текст, созданный ChatGPT, или изображения, порождённые моделью преобразования текста в картинку Stable Diffusion. Оказалось, что сети ИИ, обученные на выходных данных ИИ, как правило, сходят с ума после пяти циклов обучения на том, что сгенерировал сам ИИ. Это очевидно на титульной картинке к новости: по лицам словно прошлись напильником.
Выражение «сойти с ума» содержит в английском оригинале публикации не просто слово mad, «безумный», а аббревиатуру MAD — это сокращение от Model Autophagy Disorder, «расстройство с самопоеданием модели». Термин предложили учёные из двух университетов, Райса и Стэнфордского, которые участвовали в исследовании.
Понятие MAD означает явление, когда модели ИИ и качество результатов ухудшаются при повторном обучении на данных, сгенерированных ИИ. Как следует из термина, модель, по сути, съедает саму себя, как мифический змей Уроборос. Она теряет информацию о хвостах (крайностях) исходного распределения данных и начинает выдавать результаты, которые в большей степени соответствуют среднему значению.
По сути, обучение больших языковых моделей (LLM) на своих собственных (или чужих) выходных данных создаёт эффект конвергенции, сближения, данных, из которых состоит сама LLM. Последовательные итерации (обработки) при обучении на сгенерированных LLM данных приводят к тому, что модель теряет доступ к менее распространённым элементам.
Данные на краях, которые имеют меньше вариаций и менее представлены, по существу исчезают. Из-за этого остающиеся в модели элементы менее разнообразны и регрессируют к среднему значению. Согласно результатам исследования, требуется около пяти раундов итерации, пока не исчезнут хвосты исходного распределения — и это момент, когда наступает то самое безумие, MAD. Влияет ли расстройство аутофагии (самопоедания) на все модели ИИ, в точности пока неизвестно. Исследователи успели обкатать проблему на архитектуре нейронной сети типа автокодировщика, модели гауссовой смеси (GMM) и большой языковой модели.
Так уж получилось, что все типы моделей, которые могут сойти с ума, широко распространены. Так, автокодировщики могут прогнозировать популярность для соцсетей, сжимать изображения, подавлять шумы в картинках и генерировать новый графический контент. А модели гауссовой смеси используют для оценки плотности, кластеризации и сегментации изображений, что делает их особенно полезными для статистики и наук о данных.
Что касается больших языковых моделей, то они составляют основу современных популярных приложений для чат-ботов, в том числе ChatGPT от OpenAI и AI Claude от Anthropic. И они тоже склонны сходить с ума при обучении на своих собственных выходных данных. При растущей значимости алгоритмических моделей ИИ и в корпоративной сфере, и для рядовых пользователей — это проблема.
Итак, исследователи заглянули в чёрный ящик ИИ. И практически разрушили всякую надежду на то, что человечество обрело бесконечный источник данных. На самом деле определённые модели ИИ оказались, образно говоря, беговым колесом для хомячка: машина загружает в него данные, а затем возвращает внутрь его собственные данные, чтобы сгенерировать больше данных, которые затем возвращаются обратно.
Такой алгоритмический фанатизм не учитывает элементы, которые были изначально в меньшинстве. Результат налицо, точнее, опять-таки на лицах на заглавной картинке.
Другой важный момент — проблема происхождения данных. Теперь особенно важно иметь возможность отделять «оригинальные» данные от «искусственных». Если вы не можете определить, какие данные были созданы LLM или приложением для генерации картинки, вы можете случайно включить их в обучающие данные для вашего продукта следующего поколения.
К сожалению, этот корабль уже отчалил, пишет издание Tom’s Hardware. Уже создано некое количество немаркированных данных, созданных сетями такого типа и включённых в другие системы. Даже если бы у нас была копия всего интернета до взрыва популярности ChatGPT или Midjourney, во всемирную паутину уже давно ежедневно поступает контент, «придуманный» ИИ. И это не говоря уже об огромных объёмах того, что все эти машинные умы успели наштамповать.
Однако знание о проблеме означает, что поиск водяного знака, который безошибочно идентифицирует порождённый ИИ контент, теперь стал ещё важнее. И пропорционально выросла ответственность за маркировку того, что создано ИИ. (А ещё нарисовалась максимально прибыльная задача для разработчиков).
Однако существуют и другие способы компенсировать описанные отклонения. Один из них — просто изменить вес (в смысле науки о данных). Если увеличить релевантность или частоту результатов в хвостах распределения, они естественным образом будут двигаться вдоль колоколообразной кривой, ближе к среднему значению. Из этого следует, что тогда они были бы гораздо менее подвержены обрезке при самогенерирующемся обучении. Да, модель по-прежнему будет терять данные по краям кривой, но они будут не только там. Но это создаёт новую проблему — последствий тонкой настройки модели и того, как это повлияет на результат.
Для каждого вопроса, на который нашли ответ, возникает ряд новых.
На передний план выходят вопросы:
• истинности ответов модели, где отклонения известны как галлюцинации;
• является ли модель предвзятой и откуда берётся эта предвзятость — из самих ли обучающих данных или из процесса взвешивания, используемого для создания сети, или из MAD;
• что происходит, когда модели обучаются на своих собственных данных.
Раз уже пишут без кавычек, что ИИ сходит с ума, то возможно и другое сравнение. Люди без доступа к новому опыту тоже деградируют, становясь эхо-камерами чего-то прежнего. Когда кто-то или что- то обучаются на собственных выходных данных, — это не к добру.
- Дмитрий Ладыгин
- tomshardware.com; wikipedia.org
Наши новостные каналы
Подписывайтесь и будьте в курсе свежих новостей и важнейших событиях дня.
Рекомендуем для вас
После чудовищного Эль-Ниньо наш мир, возможно, уже не будет прежним
Первой жертвой будет Амазония, но это, как говорят ученые, только начало...
Кто на самом деле сделал Терракотовую армию: историческую сенсацию рассмотрели в отпечатках на древней глине
Поразительно, но открытие китайских ученых перекликается с исследованиями по Древнему Египту и Ближнему Востоку...
«Мы научили медведей видеть в нас добычу»: биолог рассказал, почему хищники нападают на людей по всей России
По словам ученого, совпало сразу несколько факторов, поэтому решить проблему будет сложно...
«Мясной фарш» для Гитлера: как виртуозная операция в 1943 году решила ход битвы за Италию
Дерзко, остроумно и с огромной долей везения: британский план висел на волоске, но Лондону помогли… сами немцы...
Шуховскую башню в Москве начали разбирать: почему правнук великого русского инженера против такой «реконструкции»?
Где главный промах московских властей и чем восстановление отличается реконструкции?...
Крестик XII века показал, настолько ученые ошибались в истории древнего Смоленска
Скромный артефакт из редкого материала оказался для археологов дороже серебряного клада...
Пустая еда: почему за 60 лет наши продукты потеряли половину полезных веществ и микроэлементов
По словам исследователей, мир находится в состоянии скрытого голода: калорий, вроде бы, хватает, а витаминов и минералов нет...
Самое древнее кораблекрушение в истории: что нашли турецкие ученые на судне, которое утонуло 4600 лет назад?
Подобные артефакты в свое время находили не только в легендарной Трое, но и рядом с Великой пирамидой в Египте...
Монетный детектив: российский ученый 10 лет охотился за распроданными сокровищами и раскрыл тайну древнего царства на Боспоре
Пожалуй, это одна из самых интересных исторических загадок, раскрытых в последнее время...
Почему ледник Судного дня не перестанет таять, даже если остынут моря и океаны?
Новое исследование показало: у Антарктиды есть поразительные сценарии будущего, от которых зависит судьба всего мира...
Что массово убивало пингвинов в 2024-м: ученые подозревали птичий грипп, но они ошибались
Поразительно, но виновник массовой гибели птиц больше 20 лет находился под носом у исследователей, а они его не замечали...